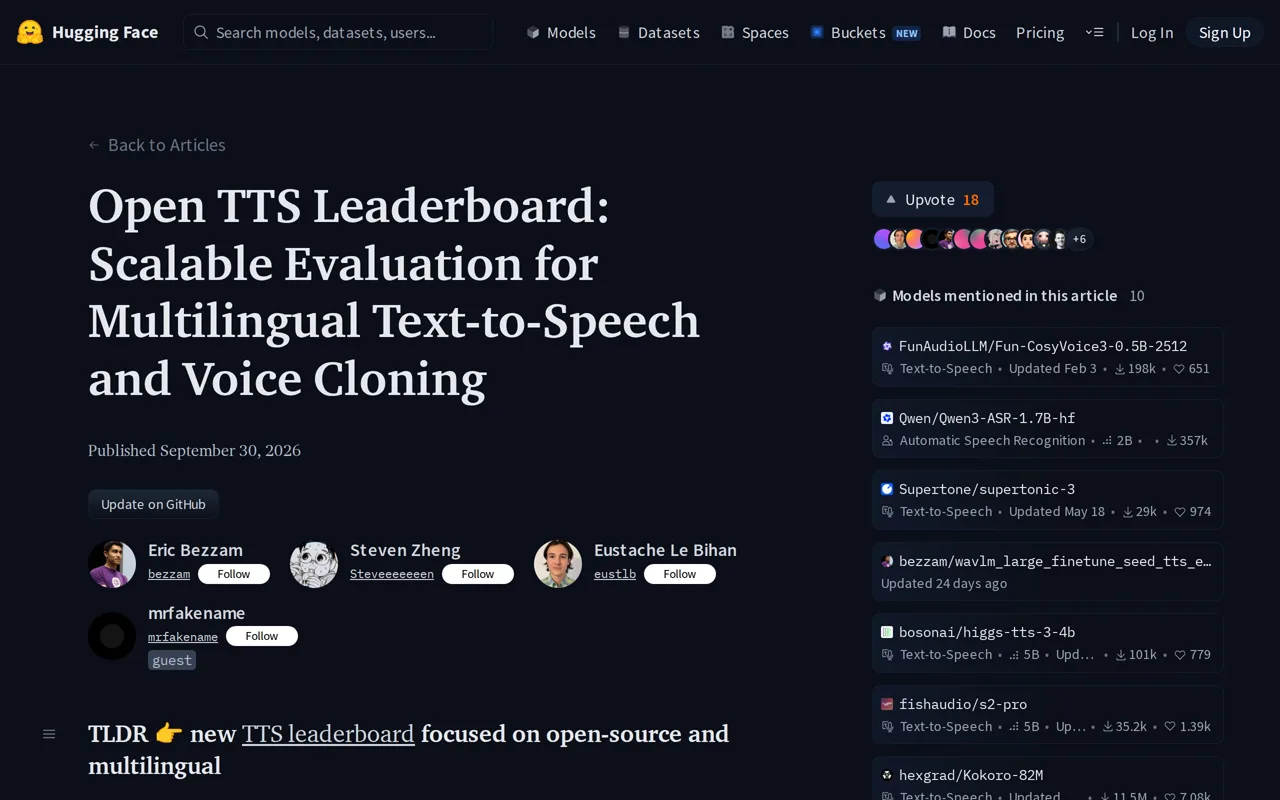
Plus de 8 000 modèles de synthèse vocale sont publiés sur le Hub de Hugging Face, mais les comparer reste difficile. L’Open TTS Leaderboard propose de les classer avec des mesures objectives : erreurs de transcription, vitesse et fidélité de la voix clonée. Il ne remplace pas l’avis des auditeurs, qu’il cherche plutôt à compléter.
En bref
- Un classement de modèles TTS open source et multilingues, annoncé le 30 septembre 2026
- Trois familles de mesures : intelligibilité, vitesse, similarité de voix
- Évaluer un modèle prend quelques heures, contre quelques semaines de votes
- Un onglet « Listen » pour écouter et voter, un onglet « Streaming » pour la latence
- Les scripts d’évaluation doivent être publiés prochainement
Pourquoi un nouveau classement
La synthèse vocale, ou TTS (text-to-speech), transforme un texte en voix. Selon Hugging Face, plus de 8 000 modèles de ce type sont disponibles sur le Hub au 30 septembre 2026. L’évaluation, elle, reste fragmentée et peu standardisée.
Les références actuelles sont des « arènes » comme TTS Arena v2, Artificial Analysis et Voice Arena. Elles font écouter deux sorties à un utilisateur, qui choisit la meilleure. Les votes servent ensuite à calculer un score Elo, souvent avec le modèle de Bradley–Terry.
Les limites des arènes de vote
D’après l’article, les arènes ne suivent pas le rythme des sorties de modèles. Les modèles open source y sont sous-représentés : sur Artificial Analysis, seuls 16 des 92 modèles ont des poids ouverts, avec un déséquilibre similaire sur Voice Arena.
Les auteurs avancent deux explications probables. Ajouter un modèle accessible par API demande peu de travail, alors qu’un modèle ouvert doit être hébergé par l’opérateur de l’arène. Autre limite : on ne peut pas garantir que les mêmes votants appliquent les mêmes critères dans le temps.
Les trois mesures utilisées
L’Open TTS Leaderboard s’appuie sur des métriques objectives. Cela réduit le temps d’évaluation d’un modèle : de quelques semaines pour collecter des votes à quelques heures, selon la source.
Ces mesures sont des approximations. Le taux d’erreur sert de indicateur de l’intelligibilité et la similarité estime la conservation de l’identité vocale, mais ni l’un ni l’autre ne mesure directement le naturel, l’expressivité ou la préférence des auditeurs.
- Intelligibilité : taux d’erreur de mots (WER) ou de caractères (CER) entre le texte demandé et la transcription de l’audio généré, produite par Qwen3 ASR
- Vitesse : facteur temps réel inverse (RTFx) en inférence par lots sur un GPU H200, et délai avant le premier son (TTFA) en traitement unitaire sur H200 et sur CPU
- Similarité de voix : similarité cosinus (SIM) entre les empreintes vocales WavLM de l’audio généré et du clip de référence
Multilingue et clonage de voix
Par défaut, les modèles sont classés selon le WER moyen sur les parties anglaises de Seed TTS Eval et de CV3 Eval (zero shot). Dans ce classement, hexgrad/Kokoro-82M, Supertone/supertonic-3 et fishaudio/s2-pro arrivent en tête. Des graphiques de Pareto montrent l’équilibre entre WER, vitesse en lots et taille des modèles.
Les résultats en anglais ne se transposent pas forcément aux autres langues, qui peuvent être activées une à une. Seed TTS Eval ne contient de l’audio que pour l’anglais et le chinois : les autres langues reposent donc sur CV3 Eval. Pour le chinois, le japonais et le coréen, langues à caractères, c’est le CER qui est affiché. Parmi les modèles multilingues solides, la source cite k2-fsa/OmniVoice, fishaudio/s2-pro et FunAudioLLM/Fun-CosyVoice3-0.5B-2512.
L’option « Voice cloning » ne garde que les modèles capables de reproduire une voix à partir d’un extrait de référence. Une colonne SIM apparaît alors, avec deux graphiques de Pareto supplémentaires. Le WER moyen de bosonai/higgs-tts-3-4b et d’openbmb/VoxCPM2 s’améliore quand un audio de référence est fourni.
Écouter et voter
Les chiffres ne disent pas tout, reconnaissent les auteurs, pour qui la préférence humaine reste l’arbitre final. L’onglet « Listen » permet d’écouter les sorties qui sous-tendent les métriques, selon la langue ou le jeu de données, avec ou sans clonage, pour des modèles choisis ou tirés au hasard.
Il est possible de donner son avis sur ces sorties. Ces votes pourraient être intégrés au classement à mesure qu’ils s’accumulent. Une connexion avec un compte Hugging Face est demandée pour limiter le spam et les robots.
La latence en streaming
L’onglet « Streaming » classe les modèles selon le TTFA, c’est-à-dire l’attente avant d’obtenir un audio lisible. Cela compte pour les agents vocaux et les applications interactives. Pour un modèle en streaming, c’est le délai avant le premier morceau d’audio ; sinon, c’est le délai avant la phrase complète.
Chaque modèle traite un audio à la fois, sur les mêmes 50 prompts anglais de CV3-Eval, avec la même machine et sa voix par défaut. Les trois premières exécutions sont écartées comme échauffement, puis la médiane est retenue. La vue par défaut porte sur H200, et des résultats CPU existent pour un petit ensemble de modèles, en croissance. Pour ce critère, la source cite kyutai/pocket-tts sur GPU comme sur CPU.
Ce que la source ne dit pas encore
Les scripts d’évaluation doivent être ouverts prochainement, sur le modèle de l’Open ASR Leaderboard, pour recueillir retours et propositions via GitHub. La source ne donne pas de date. Elle ne détaille pas non plus la procédure pour faire ajouter un modèle, ni de tarif éventuel.
Questions fréquentes
Cet Open TTS Leaderboard remplace-t-il les arènes de vote ?
Non. L’article précise qu’il ne remplace pas le classement par préférence humaine. Il peut en revanche indiquer aux classements par votes quels modèles intégrer à leurs évaluations.
Combien de temps faut-il pour évaluer un modèle ?
Selon la source, l’évaluation passe de quelques semaines, le temps de collecter des votes, à quelques heures grâce aux métriques objectives.
Que mesure la colonne SIM ?
Elle apparaît quand on active le clonage de voix. Elle donne la similarité cosinus entre les empreintes vocales WavLM de l’audio généré et du clip de référence.
Les langues autres que l’anglais sont-elles couvertes ?
Oui, plusieurs langues peuvent être activées. Hors anglais et chinois, les scores viennent de CV3 Eval, et le CER remplace le WER pour le chinois, le japonais et le coréen.
À retenir
L’Open TTS Leaderboard classe des modèles de synthèse vocale ouverts et multilingues avec des mesures objectives, en quelques heures par modèle. Ces mesures complètent le jugement des auditeurs sans le remplacer, et les scripts d’évaluation doivent être publiés prochainement.